不敢相信居然有人把......豆包做AI短视频的完整路线玩明白了!从找文案到成片,一套流程全跑通
前阵子一直有人问我,治愈系AI短视频到底是怎么做出来的。
其实只要把流程拆开以后,并没有想象中的那么复杂。最容易把人劝退的,反而是刚开始东学一个工具、西试一个方法,文案没定好就去出图,图片没统一就又急着做视频,反到最后却是越做越乱。
这次我把自己顺下来的一套方法重新整理了一遍,核心就两个工具:豆包负责前面的文案、出图和图生视频,剪映负责后面的剪辑、字幕、配音和音乐。
对新手来说,先把这一套跑通,比一开始研究一堆复杂工具实用得多。
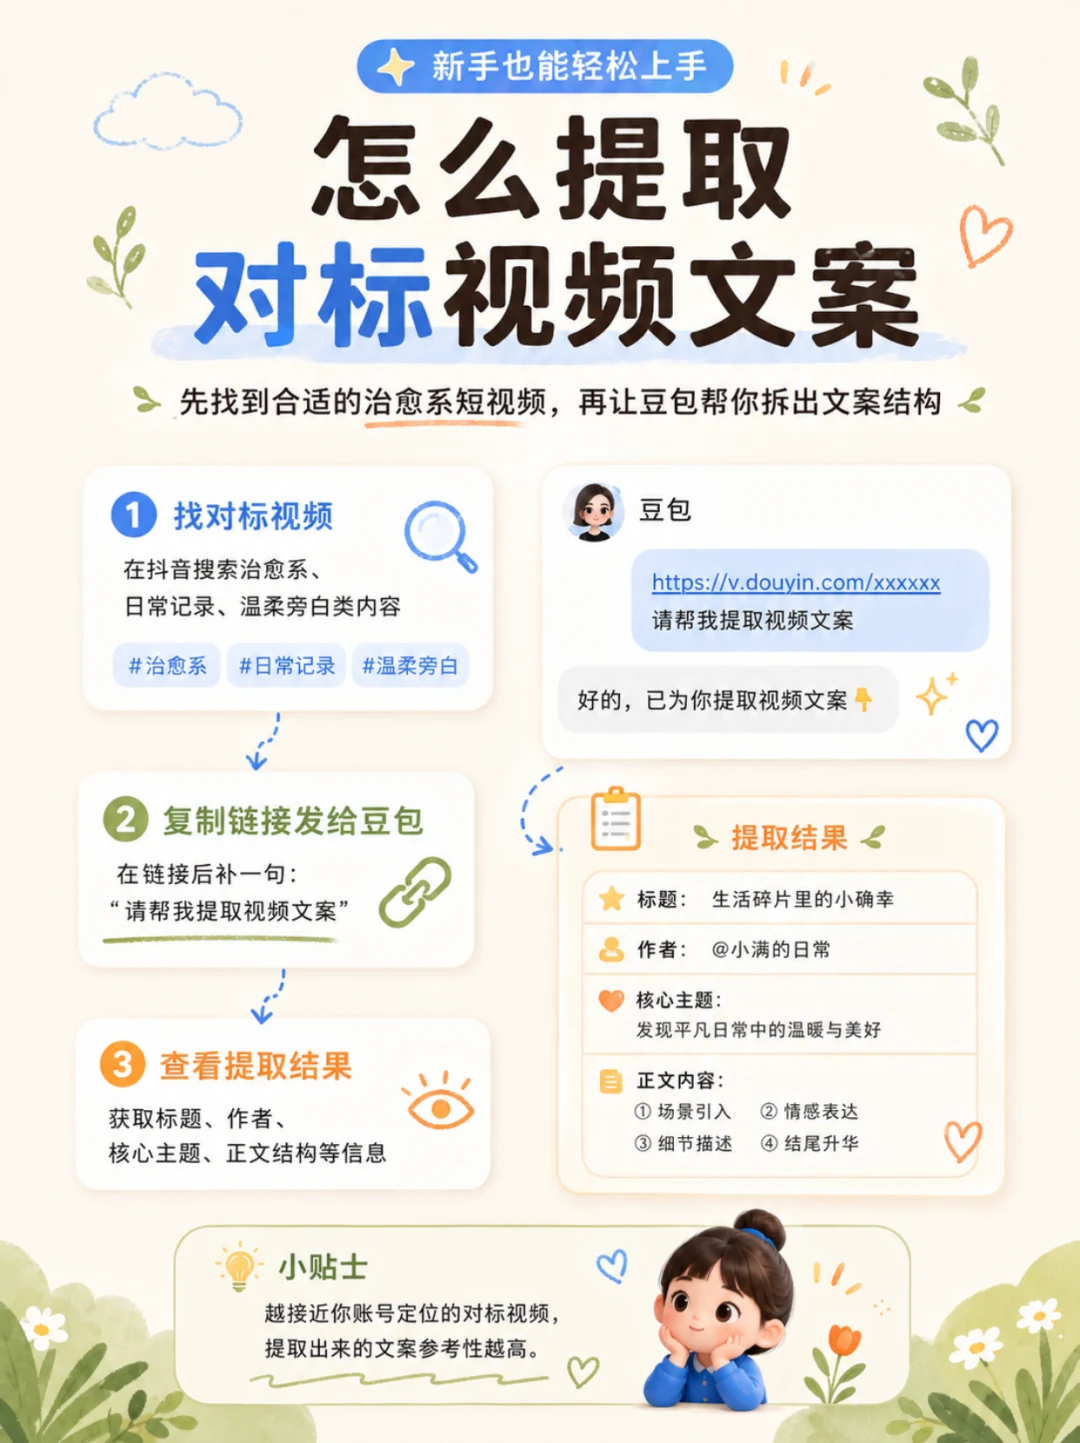
一、先找一个你想做的参考视频
第一步就不要急着自己凭空写。可以先去抖音、小红书这类平台找几条你喜欢的治愈系视频,比如:
日常治愈、情绪旁白、古风小女孩、田园生活、萌娃动画……
最好找那种画面、文案、节奏都比较接近你想做方向的内容。找到以后,把视频链接复制下来。
接着打开豆包,把链接发进去,再补一句:
帮我提取这个视频的文案,并整理标题、核心主题和正文结构。
二、再让豆包重新写一版自己的文案
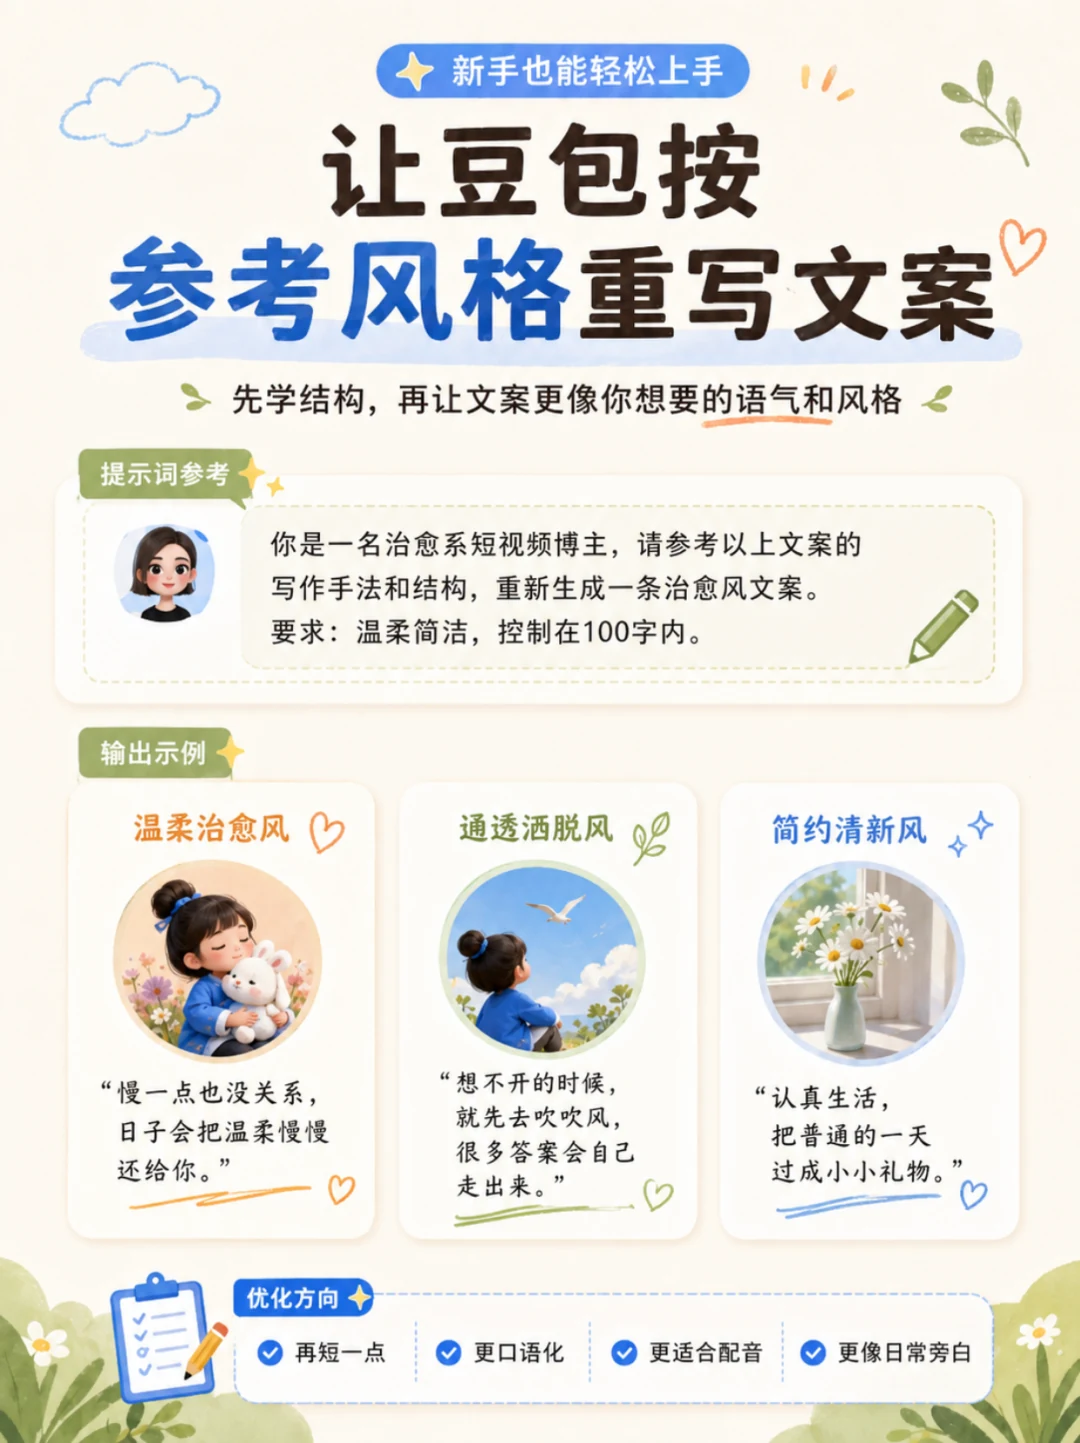
当文案提取出来以后,我是不建议大家直接拿来做。可以再继续让豆包重写。
比如可以输入:
你是一名治愈系短视频博主,请参考上面文案的结构和表达方式,重新写一条原创治愈系旁白。
要求:温柔自然、口语化、100字以内,适合女声配音,不要太鸡汤。
三、根据文案拆成几个画面
当文案确定后,也不要立刻整段就拿去生图,而是先拆场景。
比如有一句:
“要好好生活,在日子里收集温柔与快乐。”
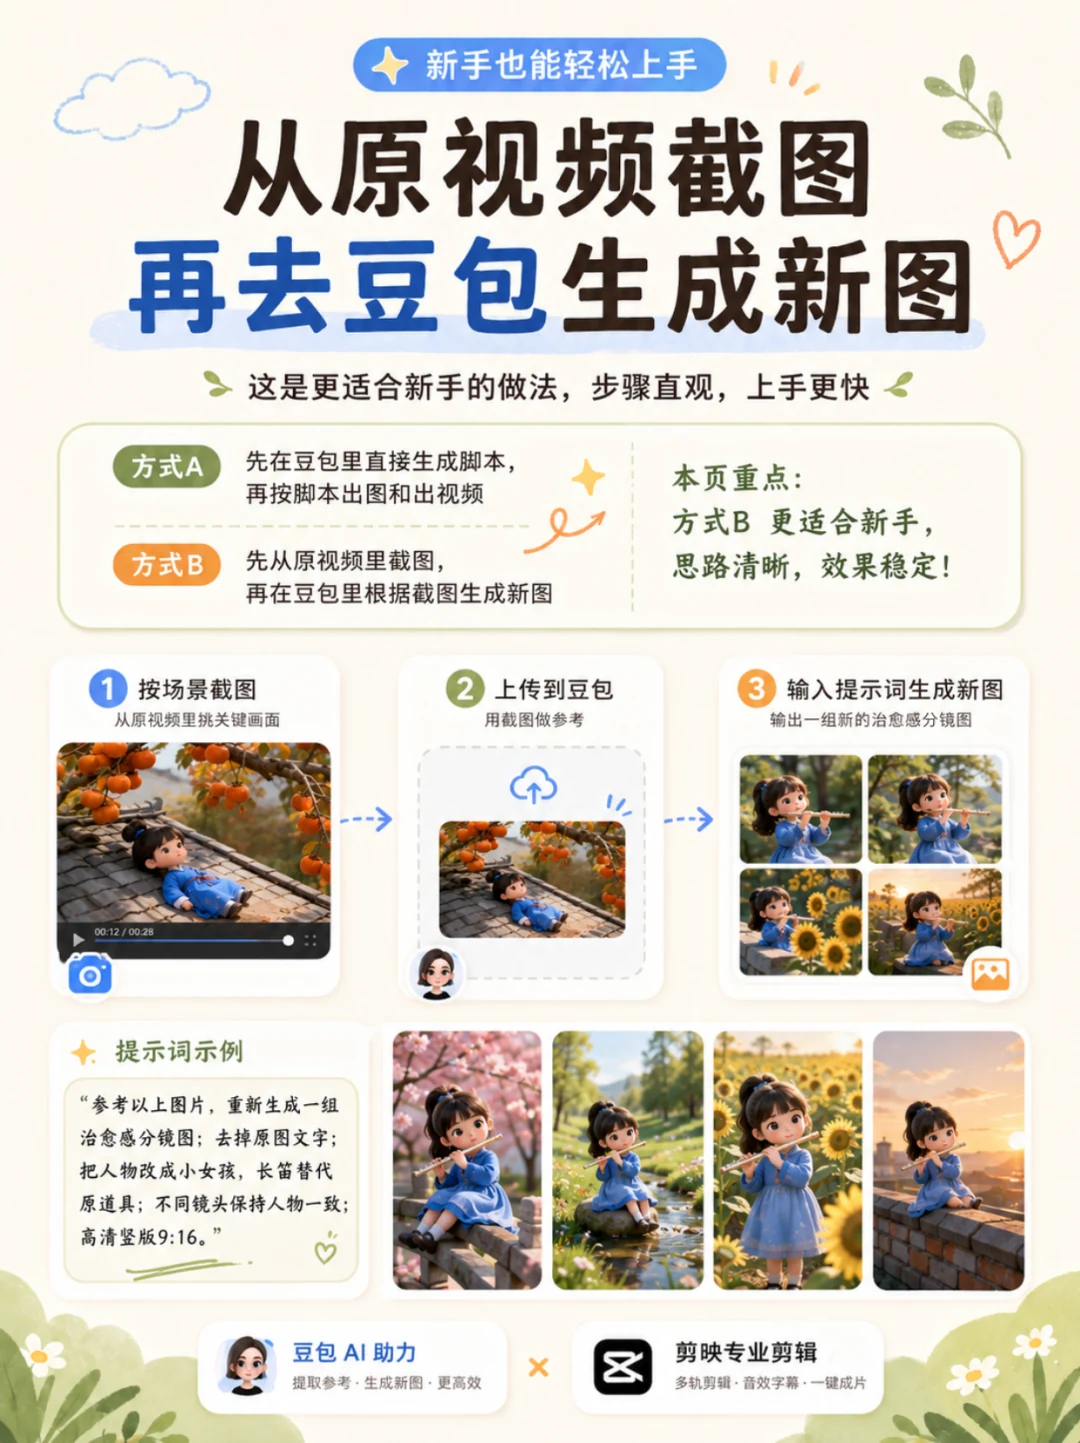
四、从参考视频截图,再让豆包重新生成画面
对于刚上手或者是刚开始做的人,我更推荐这个方法,不用一上来就自己研究特别复杂的提示词。直接从参考视频里截几张你觉得构图不错的画面。然后把截图上传到豆包,让它参考画面重新生成。
比如原图里是一个男孩坐在屋顶,你可以改成:
参考这张图片的构图重新生成。
人物改成8岁左右的小女孩,黑色丸子头,穿蓝色古风长裙。
保留屋顶和柿子树场景,去掉原图文字。
画面温暖治愈,柔和自然光,高清竖版9:16。
五、人物跑偏,不要整组重新生成
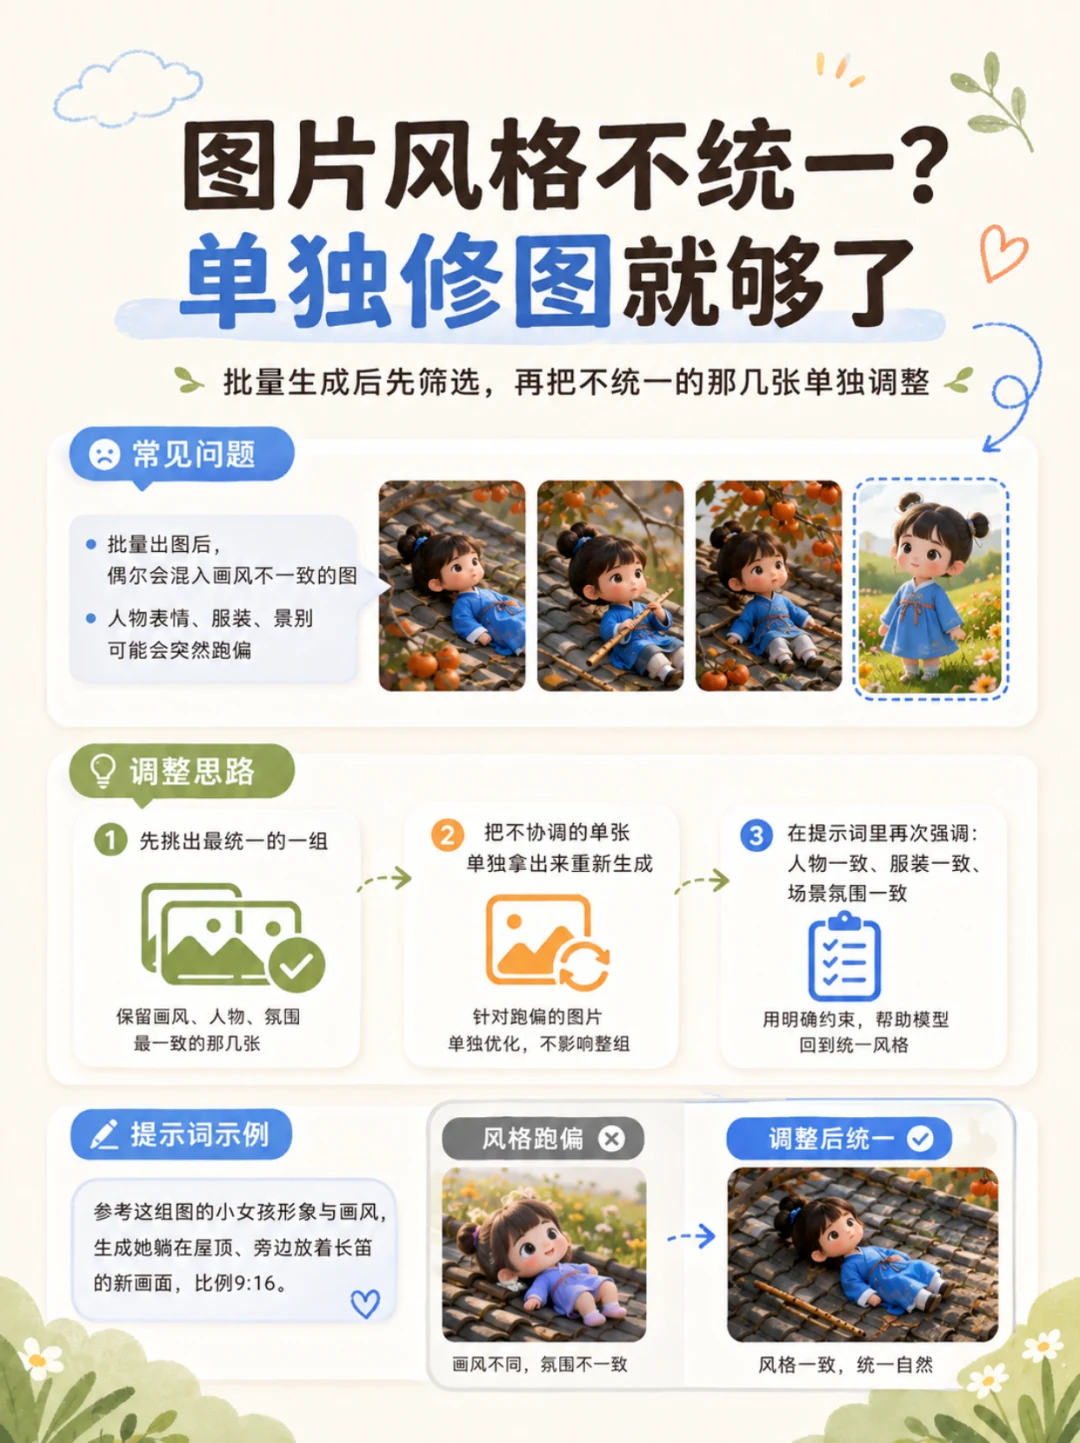
AI批量出图特别容易遇到一个问题:比如第一张还是这个小女孩,到第三张脸变了,第五张衣服又换了。这时候别直接整组重做。
先把比较统一的图片挑出来。然后把跑偏的单张重新丢给豆包,明确要求:
参考前面人物的脸型、年龄、发型、蓝色服装和整体画风重新生成。
人物保持一致,只修改当前场景和动作。
六、图片确定后,开始做图生视频
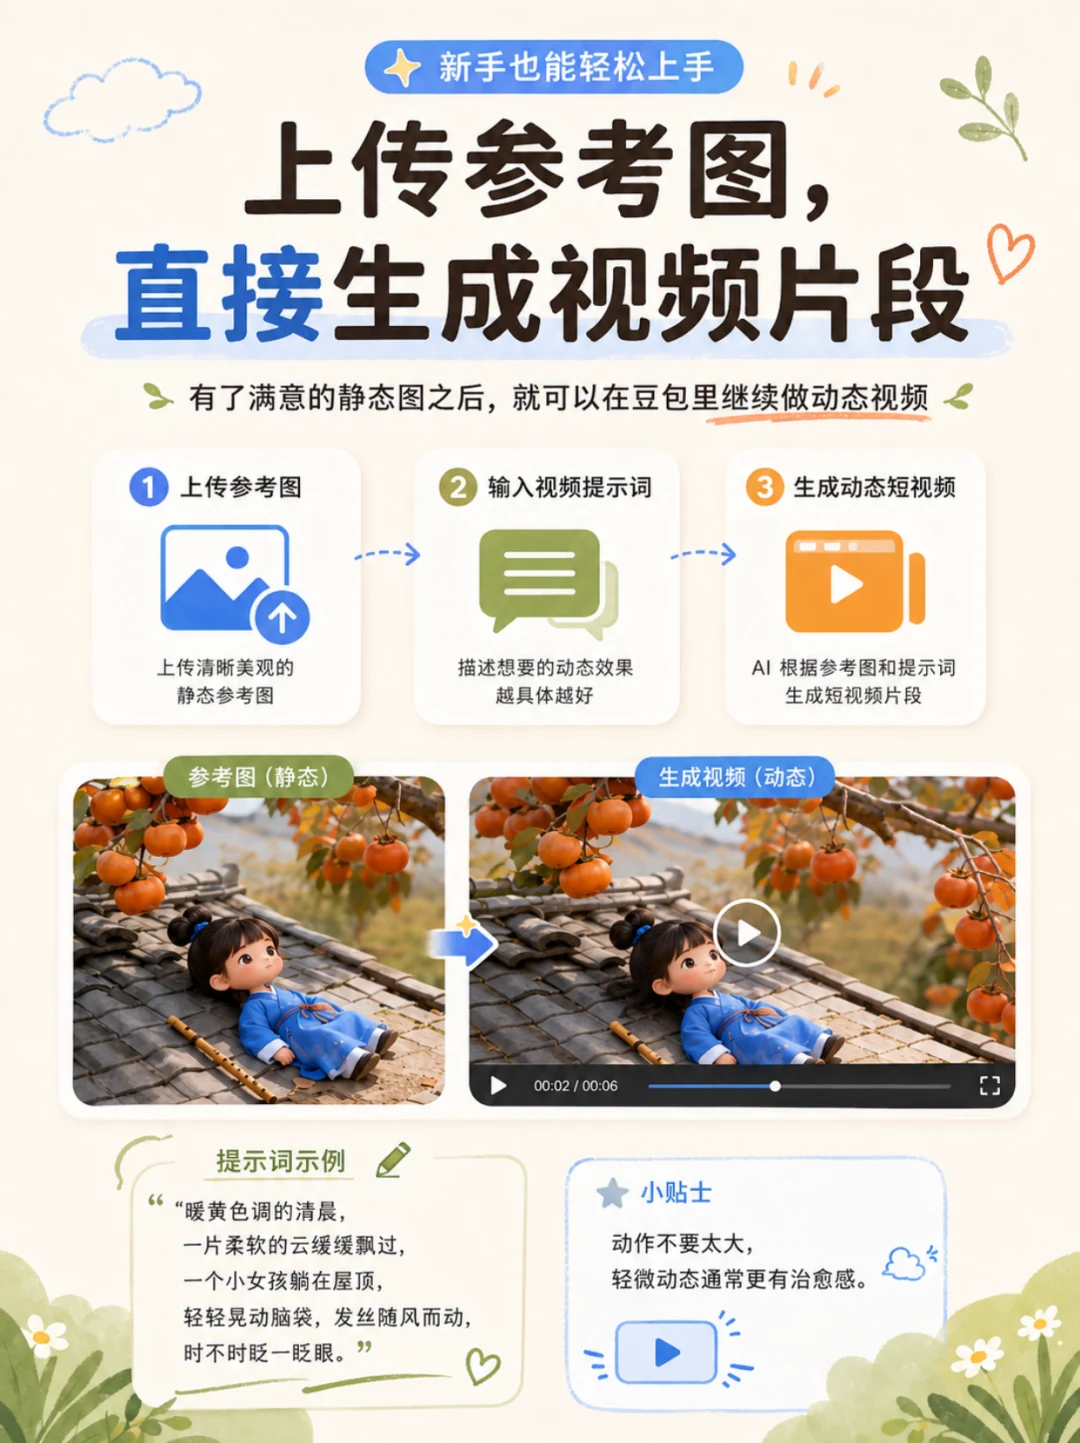
当觉得自己的静态图制作满意之后,就可以直接用豆包的视频生成功能。上传其中一张图,然后写动作。这里有个小经验:治愈系视频千万别把动作写得太大。
例如不要一上来就:“女孩快速起身转圈,然后奔跑。这样会很容易让画面崩掉。
更适合的是:
清晨暖黄色光线,小女孩安静躺在屋顶,头发被微风轻轻吹动,缓慢眨眼,衣角轻微摆动,树上的柿子和叶片随风晃动,镜头缓慢推进。
七、所有视频做好后,统一放进剪映
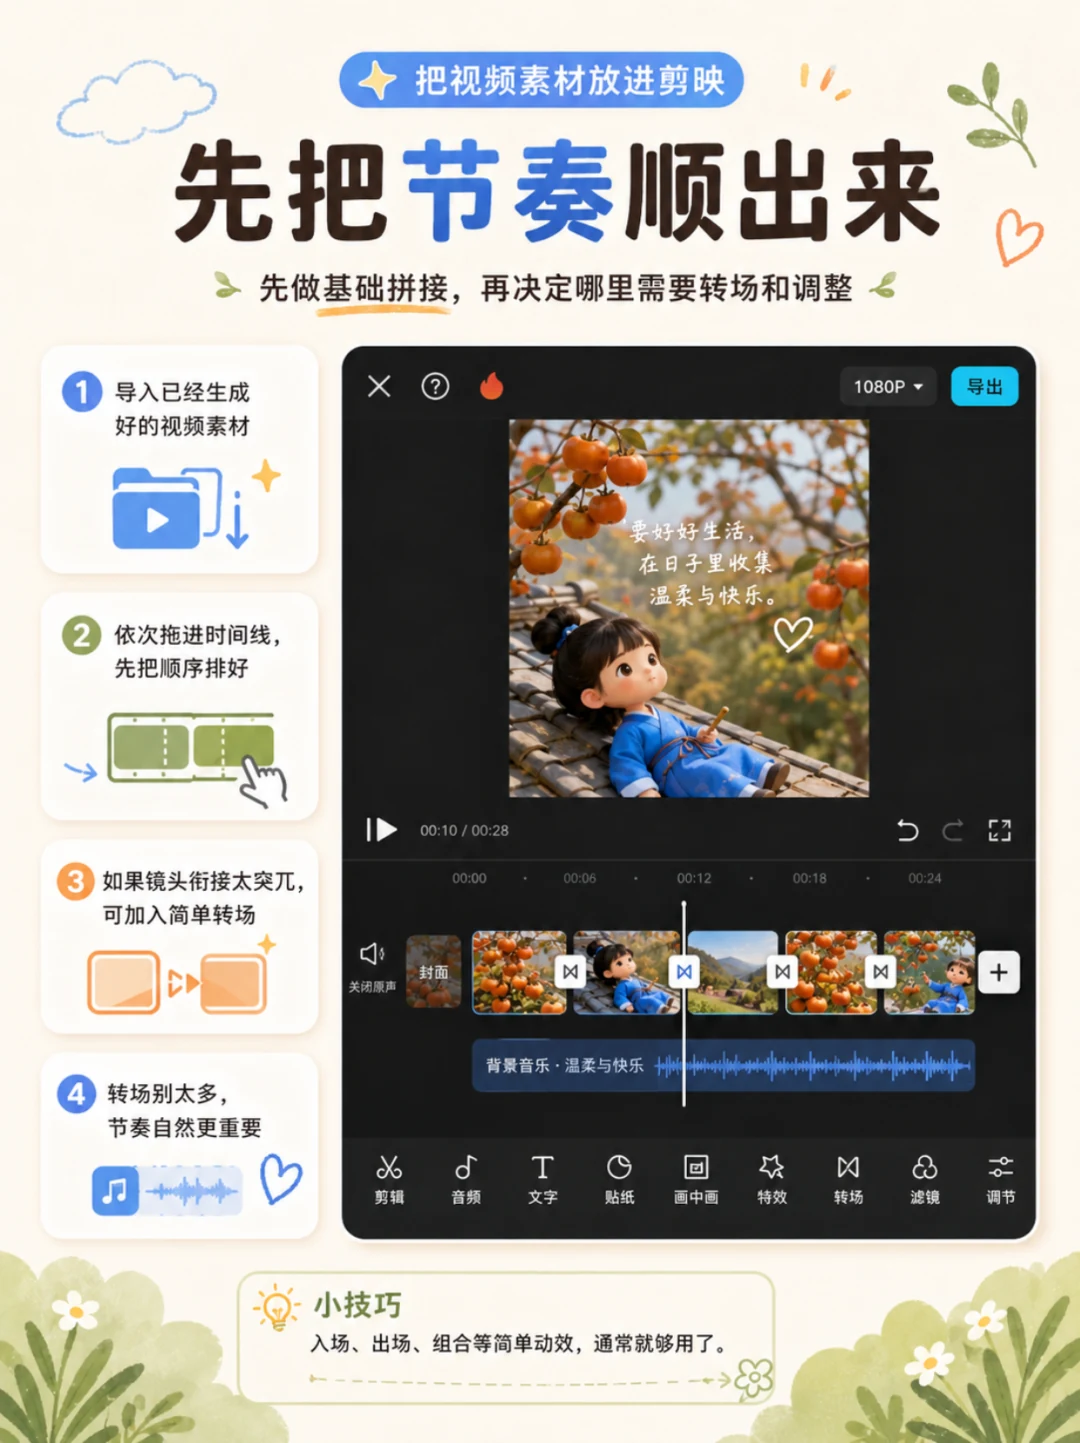
接下来进入剪映。先别急着加字幕、音乐和特效。第一件事就是排顺序。把所有AI生成的视频按照故事顺序拖进时间线。
八、把前面写好的文案做成字幕和配音
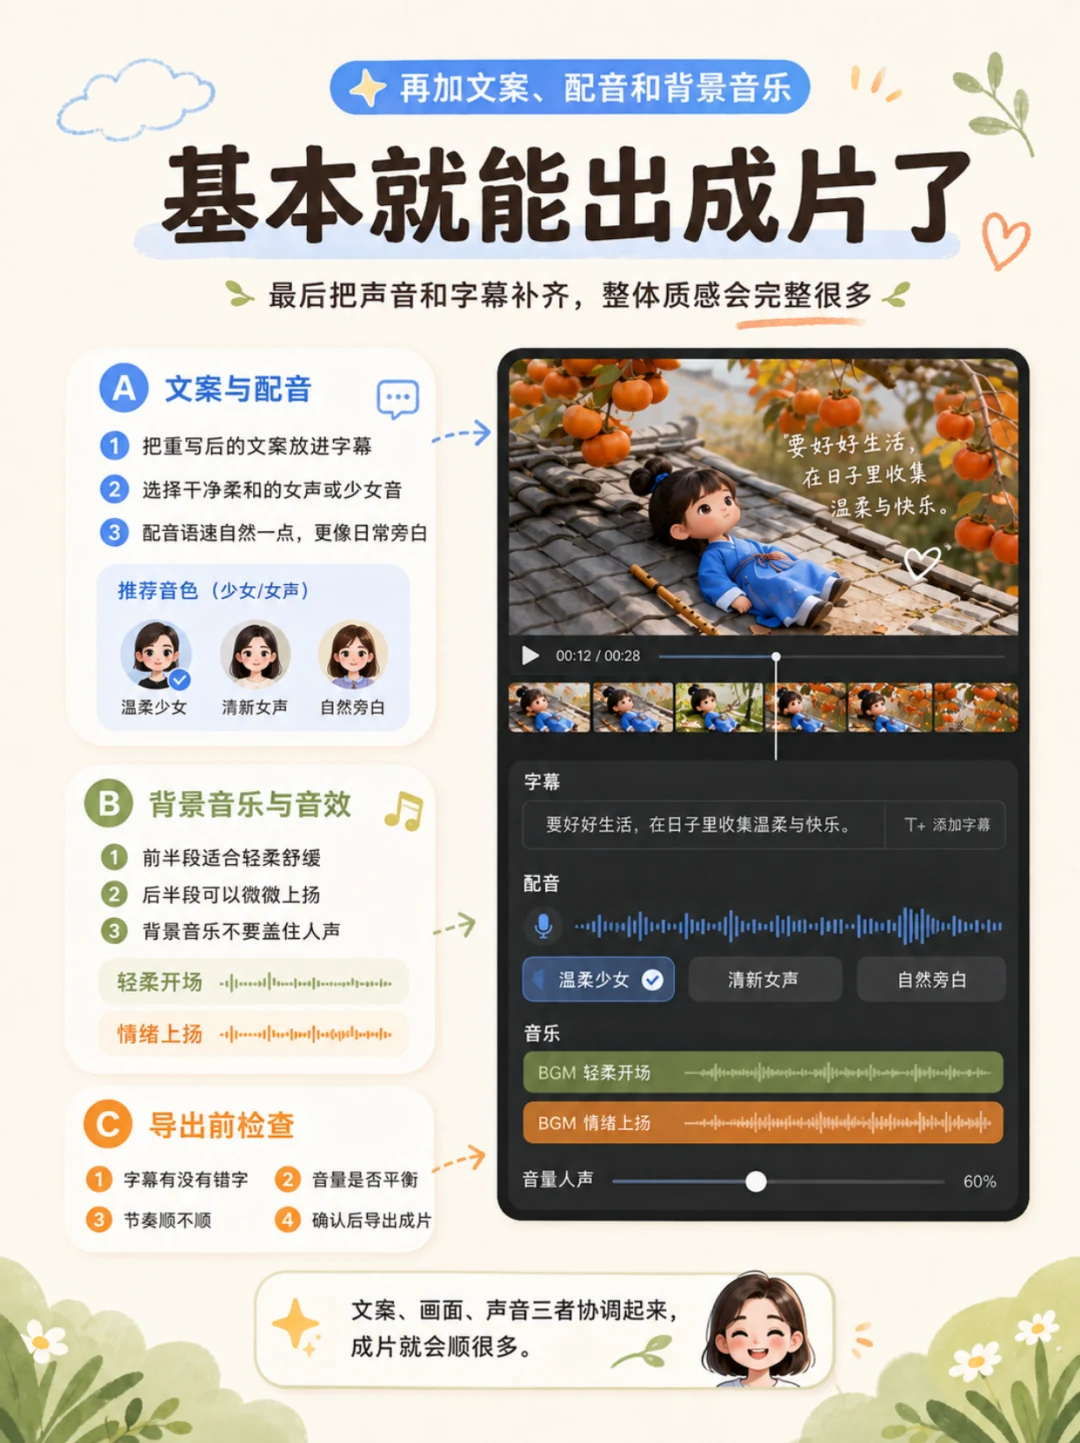
画面顺了,再加文案。把前面豆包写好的旁白导入剪映。字幕不用搞得太复杂。白字、米白、浅黄色都可以,根据画面调整。然后选配音。治愈系比较适合:温柔女声;自然少女音;轻柔旁白。尽量别选特别播音腔的声音。语速可以稍微慢一点。有些句子之间留个0.5秒左右的空白,听起来反而更舒服。
九、最后补背景音乐和音效
配音完成以后,再选BGM。背景音乐最好是那种:钢琴;轻吉他;治愈纯音乐;轻柔氛围音乐。音乐音量不要太大。旁白始终是主角。如果视频后半段情绪有变化,可以前面用比较舒缓的音乐,后面稍微增加一点情绪。还可以加少量环境音:风声;鸟叫;树叶声;流水声。不用全部都加。合适的地方点一下,画面就会更有氛围。
十、导出之前,再完整检查一次
我现在每次导出前都会从头到尾重新看一遍。重点检查:字幕有没有错字;人物有没有突然变脸;音量有没有忽大忽小;镜头切换会不会太急;BGM有没有盖住配音;结尾有没有突然断掉。没问题以后,再导出成片。
 一条完整的制作流程其实就是这几步:
1 | 找对标视频↓豆包提取文案↓重新写原创文案↓拆分镜头和场景↓截图作为参考图↓豆包生成新图片↓修正人物一致性↓图片生成视频↓剪映排列镜头↓添加字幕和配音↓加入BGM和音效↓检查并导出 |
所以刚开始不用追求工具有多高级。先用豆包+剪映,把一条完整的视频从头到尾做出来。流程跑通以后,再慢慢研究角色一致性、镜头语言和更专业的视频模型,反而更容易上手。