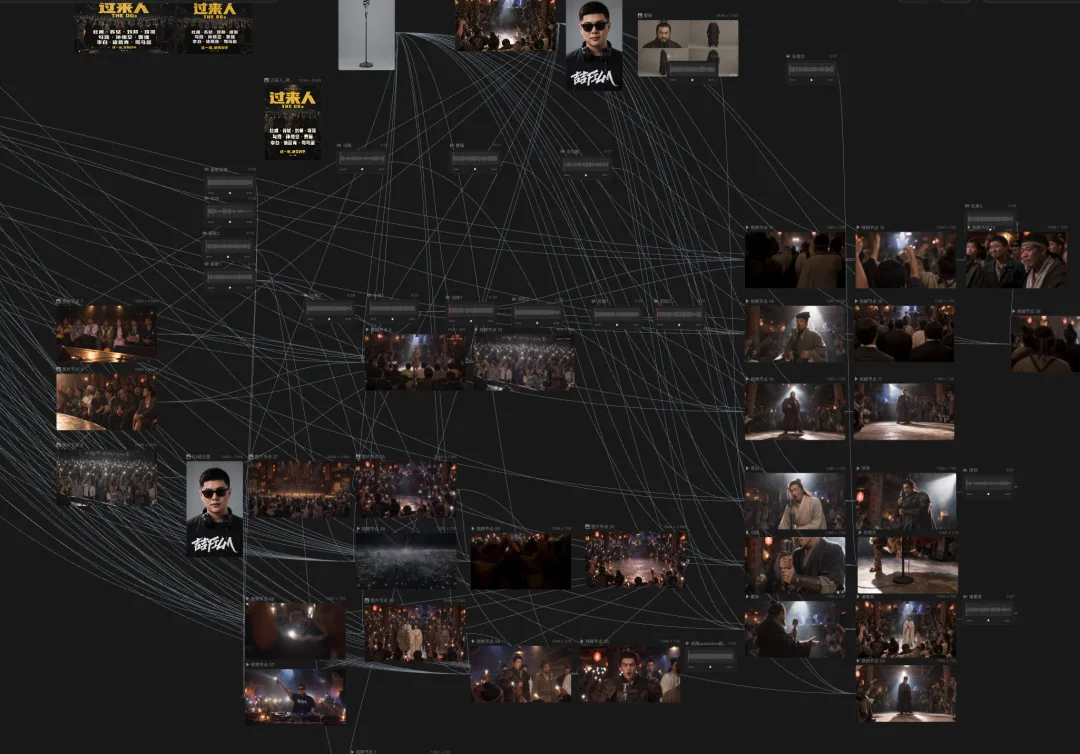
如果你用AI做过图、做过视频,你的电脑收藏夹里大概率躺着一堆「万能提示词模板」:主体加动作加场景,结尾缀一串 2K、ultra detailed、masterpiece,像一段念给机器听的咒。今天下午我把全网播放1.24亿的AI说唱MV《过来人》的公开画布整个扒了下来——67个节点、全部24个视频镜头的提示词原文,一个不落地存了下来。2026年的提示词,和去年已经不是同一个物种了。我们来做一次「解剖」:把两套提示词摆在一起对比,看看这一年到底发生了什么。是工具更聪明了?是写法变简单了?还是写提示词这件事本身,已经换了赛道? 建议先收藏,后面每一段都可以直接抄。 # 一、先认识一下这份「作业」 《过来人》是创作者喆FILM(王琨喆)在LibTV无限画布上做的AI说唱MV。杜甫、苏轼、刘邦、项羽、勾践、孙悟空、曹操、李白、诸葛亮、司马懿,十位古人站在livehouse舞台上唱当代人的疲惫。制作周期三四天,直接成本几千元,上线一天点赞破百万,目前播放量 1.24 亿左右。整张创作画布连同全部提示词已经公开,任何人都能打开看、复制、修改。喆说:「就算我不公开,别人截图也能反推提示词,不如开放。」反推?没有公开的精确!图:《过来人》公开画布全览。左侧为19段音频切片与人物资产图,右侧为24个视频镜头节点及素材引用连线。来源:LibTV 公开创作过程页截图上面这张截图就是它的「创作过程」页:左边是19段音频切片和人物资产图,中间和右边是24个视频镜头节点,密密麻麻的连线是素材引用关系。作者在采访中说过一句话:「屏幕上很多线看似连来连去、密密麻麻,但逻辑非常清晰。」本文的素材,全部来自这张画布的原始数据,用过 liblib 的人都知道,看上去复杂,但实际操作很简单。如果你用过 Shake、Nuke、DigitalFusion 这类节点式合成软件, 那么用这个工具简直就是小儿科。 # 二、去年的提示词长什么样 先回忆一下2025年主流的AI生成提示词写法。不管是文生图还是早期的文生视频,基本是这个结构:一段式咒语:主体描述+动作+场景+风格,最后用逗号分隔堆一串质量词——「8K resolution, ultra detailed, masterpiece, best quality, cinematic lighting」。写法是「关键词拼接」,每个词像往许愿池里扔一枚硬币,扔得越多越好,没人知道哪枚管用。万能模板:网上流传各种「提示词公式」,人物、风景、产品各一套,改几个词就能用。还有很多某鱼的教程,现在已经贬值到 0.01 元一套了。其实呢,大家的提示词长得都差不多,生成出来的东西也差不多。去年很多人都是抽卡心态:写一段提示词,生成,不满意,微调一个词再生成,靠运气撞出好结果,应该是被抽卡的游戏坑过,所以叫「抽卡」。负面提示词是技术活:图不行,就加 negative prompt——「不要多余的手指、不要变形、不要文字」。抽多了,你就先知道模型会犯什么错,有经验了,可以用负面提示词预防。运镜靠术语:想让镜头动,就写「dolly in」「pan left」,写多了模型也不一定听。这不是哪一个人的写法,是整个2025年的平均水平。AI像一个听力很好但理解力有限的实习生,你得用它能听懂的句式和词汇,还得碰运气。 # 三、《过来人》的提示词长什么样 现在看2026年的。以下全部摘自画布原文,我选了一段视频的提示词来分析:先看一段标准的单人镜头提示词(杜甫主歌段),注意它的「段落结构」,而不是某个词:【素材】{{Mixed 1}} 杜甫资产图、{{Mixed 2}} 舞台场景图、{{Mixed 3}} 立式麦克风、{{Mixed 4}} 音乐切片【场景】小型 live house 演唱会现场,舞台中央立着一只复古立式麦克风(银色镀铬大振膜、圆形金属网罩、镀铬立杆、圆形配重底座,像格莱美现场那种,不是手持带线话筒);暖钨丝灯与追光,光束里有轻烟和尘埃……【动感基调】镜头全程手持肩扛、带明显呼吸感晃动;歌手站在立式麦克风前,身体随节拍自然起伏、点头、踏脚、左右摇摆,绝不僵立……【运镜】手持围绕杜甫缓慢半环绕(中近景为主),跟着节奏小幅度推拉,偶尔切观众反应再回到杜甫。【逐句动作】「屋子都快散架」抬手比划屋顶、苦笑;「安得广厦」摊开手掌、语气放缓;「别人的锁」手指虚捏像拎钥匙;「工牌」在胸前轻拍;「房贷、学费、体检单」一根一根数手指,最后轻轻叹气。动作小而真,身体始终随节拍。【嘴型锁定】 严格按本段音乐切片对嘴型,每一秒都按切片演唱,不改变节奏、不重复、不跳拍子,歌词如下:(全文照贴) 再看一张图——这是画布里的十人合唱站位图,每一排、每个人站哪、用哪支麦克风,都是提示词里逐人绑定的结果:![](/img/wp/wo-ba-yi-bo-fang-de-gu-dda099-img_02.webp)图:十人两排合唱站位图——前排5人各一支立式麦克风、后排5人共用2支,站位与用麦方式均由提示词逐人绑定。来源:画布生成素材还有观众席。下面这张「灯海」不是视频截图,是提示词生成的静态图:外卖骑手服、快递工服、松开领带的白衬衫、反光背心、背着婴儿背带的年轻妈妈——职业细节全是提示词里一个一个点名的:生图提示词: 小型 live house 观众席从舞台往下看的全景,几百个中国城市上班族站满整个场子,全部举着手机、打开手电筒,手臂举过头顶,白色光点铺满黑暗,所有手臂往同一个方向倾斜,很多人张着嘴在跟唱,有人闭眼,有人是要流泪的感觉。穿着混在一起:外卖骑手服、快递工服、灰色卫衣和工牌、松开领带的白衬衫、反光背心、polo 衫加腰包的小老板、球衣、工厂蓝色工装、背着婴儿背带的年轻妈妈、牛仔外套的大学生、穿旧夹克戴老花镜的五十多岁大叔。写实摄影,手机白光是唯一的点光源,16mm 胶片颗粒,无荧光棒、无 LED 屏、无字幕无文字。 ![](/img/wp/wo-ba-yi-bo-fang-de-gu-dda099-img_03.webp)图:观众席「灯海」。外卖骑手、快递工、松开领带的销售……职业细节全部来自提示词逐一点名。来源:画布生成素材 # 四、五个根本不同 把两套写法摆在一起,差异不在词藻,在「体裁」。第一,从「念咒语」变成「派工作」。去年的提示词是在描述一个画面,今年的提示词是在给岗位发工作单。你看【素材】条款的写法:「{{Mixed 1}} 是人物资产图,只采用他的外貌、发型、服装和年龄感,不采用背景;{{Mixed 2}} 是舞台场景图,采用空间、舞台、灯光和观众席的布局」——每个素材编号干什么、不干什么,写得清清楚楚。这已经不是提示词了,这是制片主任给各部门下的单。第二,从「一次成型」变成「迭代改造」。画布里的场景图不是一次生成的,是一条五轮的改造链:初版古代酒馆→改成暗调氛围光加观众手机灯海→舞台扩大一倍站两排人→放进7支立式麦克风→十人入画。每一轮只改一件事,并且每轮都叮嘱「保持重要特征和基本环境」。去年流行的是一次写好一段「完美的」提示词;今年被验证有效的做法是:先出个毛坯,再带着上一版结果一步步改。第三,从「质量词咒语」变成「负面清单加锚点」。「8K、ultra detailed」这类词在《过来人》的提示词里几乎绝迹,取而代之的是大量精确的「不要」:不要荧光棒、无LED屏、无字幕无文字、不要卡通、不要渐变、不要错位套印。同时有一套「锚点描述」全片复用——「暖钨丝灯与追光,光束里有轻烟和尘埃」这段话在每个镜头里原样出现,保证几十个镜头看起来在同一个场地。咒语追求的是「让模型发挥更好」,负面清单和锚点追求的是「让模型别自由发挥」。第四,从「运镜术语」变成「分镜工作单」。最让人意外的是那个「一镜到底」模板,镜头运动被拆成四个阶段:0到5秒摇臂大全景下降推进、5到10秒穿过观众侧脸降到视线齐平、10到20秒轨道横移15度推近到胸口以上、20秒后拉回中景收尾。这已经不是提示词,这是导演给摄影组写的分镜脚本,只是执行者从摄影师换成了模型。 **第五,从「抽卡」变成「立规矩」。每个镜头结尾都有一条【嘴型锁定】:「严格按音乐切片对嘴型,每一秒都按切片演唱,不改变节奏、不重复、不跳拍子。」动感条款里反复出现「绝不僵立」。十人合唱的镜头还附一致性条款:「全片共10人、每人只有一个,无重复角色、无人脸互换、无换装;后排始终站在高一级平台,两排不塌成一排。」去年我们祈求模型别犯错,今年直接给它立了规矩,而且模型听得懂、做得到。 # 五、所以,到底是谁变聪明了 结论有三层。1、工具确实更聪明了。现在的视频模型能吃多模态混合输入:人物资产图、场景图、麦克风产品图、音乐切片,一口气十几个参考文件各管各的用途(画布里的 mixed2video 模式就是这么干的);能听懂几千字的长指令并照章执行;平台还提供了资产管理,人物图存一次,几十个镜头引用同一张,跨镜头「不变脸」。这些能力在去年的主流工具上不存在。2、写提示词确实「更容易」了。你不用再背咒语、研究权重、记一堆参数术语。用自然语言把需求说清楚、把边界划明白,就能干活。2026年的提示词更像一份普通的工作交接文档,谁都会写。3、但门槛没有降低,只是换了位置。注意一个事实:《过来人》的视频废片率仍然高达3:1到5:1,作者说大量时间花在前期提示词打磨上。工具能执行「逐句动作」的前提是,你得先写出「房贷、学费、体检单,一根一根数手指,最后轻轻叹气」这样的句子——这需要的是对生活的观察、对表演的想象力、对节奏的审美。换句话说:咒语失效了,因为模型已经听得懂人话;但「说清楚要什么」成了新的分水岭。作者有句话可以作为这节的注脚:「AI可以做大量freestyle,帮我试无数句子,但它掏不出我心底的东西。」 # 六、给你留一份能直接抄的作业 我把这套提示词整理成了模板库,按用途分好了类: 人物怎么定型(四视图资产图模板+十位古人的气质速查表);单人镜头怎么写(含逐句动作句式);一镜到底怎么分阶段;十人合唱怎么防变脸;观众群像、封面海报、场景迭代链,各一份。如果你也在做AI音乐或AI视频,这套东西值得放进收藏夹——下次开新项目时,先翻它再动笔。 老规矩,几张说明图来自画布原始素材,文章里的提示词节选都可以在公开画布上核对。例如杜甫这段歌词的30 秒视频:
视频:杜甫主歌视频。来源:作者公开流程图截取 附:杜甫镜头提示词:素材职责: {{Mixed 1}} 是<人物>的人物资产图,只采用他的外貌、发型、服装和年龄感,不采用背景; {{Mixed 2}} 是 live house 舞台场景图,采用空间、舞台、灯光和观众席的布局; {{Mixed 3}} 是舞台立式麦克风,只采用麦克风和支架的外形与材质,不采用它的灰色背景,每一段都是同一支; {{Mixed 4}} {{Mixed 5}} 是观众群像参考,只采用观众的穿着和人群构成,不采用其中的舞台和灯光。 {{Mixed 6}} 是本段歌曲切片,作为 {{Mixed 1}} 的演唱内容: {{Mixed 1}} 的口型与 {{Mixed 6}} 里的人声逐字同步,不自行配音、不改歌词、不重复、不跳拍。主体设定: {{Mixed 1}} 站在舞台中央的立式麦克风前,左手扶着 {{Mixed 3}} 麦克风,他带着各种手势和肢体动作对着台下的观众表演,台下的观众也各自随着音乐点头,律动:场景: {{Mixed 2}} 小型 live house,一束暖钨丝追光从正上方打在他身上,光束里有薄薄的烟;舞台后侧暗处隐约站着其他古人的剪影,不动;台下坐满、站满观众,都是今天的城市上班族(穿着以 {{Mixed 4}} {{Mixed 5}} 为准)。阶段一(0–5 秒,第 1–2 句):开始时是摇臂大全景,机位在观众席最后排的上方,俯视整个场子:前景是一排排观众的后脑勺和肩膀(虚焦),舞台在远处一束追光里, {{Mixed 1}} 已经站在麦克风前开口唱。摇臂一边缓慢下降一边向前推进,越过观众的头顶。结束时镜头降到观众席中段、离地两米, {{Mixed 1}} 在画面正中,中远景。阶段二(5–10 秒):镜头继续向前,从前排两个观众的侧脸之间穿过(前景虚化掠过),降到和他视线齐平,推到中景,微微仰角;阶段三(10–20 秒):镜头沿轨道缓慢向右横移约 15 度,同时推近到 {{Mixed 1}} 近景(胸口以上),追光的光束和薄雾在他身后;阶段四(20–结尾):镜头缓慢后拉回中景,一个观众的肩膀从画面左下角虚化地进入前景,唱最后一句时他<收束动作>。结束时中景,他站在原位手扶麦杆,前景的观众肩膀静止,追光和站位保持。镜头总则:一镜到底,全程不切镜、不转场、不黑场、不换机位;只有摇臂和轨道的平滑匀速运动,没有手持晃动,没有变焦跳跃。声音:全程只用 {{Mixed 6}} ,不额外生成音乐、音效和人声;观众不出声。{{Mixed 6}}画面呈现:颁奖礼级演唱会的电影感:大画幅电影镜头、浅景深、前景虚化,暖钨丝追光加薄雾,暗部干净,轻微胶片颗粒;画面里无字幕、无水印、无任何文字。保持一致: {{Mixed 1}} 的脸、发型、服装、年龄全程不变;麦克风位置不变;舞台方向不变(观众始终在镜头这一侧);全程只有他一个人在舞台光里,没有第二个人上台;观众不举手机、不张嘴。一镜到底,不切镜、不转场、不黑场、不换机位,只有摇臂和轨道的平滑匀速运动,没有手持晃动。画面呈现:颁奖礼级演唱会的电影感,大画幅电影镜头、浅景深、前景虚化,暖钨丝追光加薄雾,轻微胶片颗粒;画面里无字幕、无水印、无任何文字。保持一致:人物的脸、发型、服装、年龄不变;麦克风不变;舞台方向不变;观众是现代上班族,没有古装观众;观众不张嘴说唱;手电筒是手机白光。声音只用 {{Mixed 6}} 。最后:感谢作者开放了复制和修改,他只有两个请求:别冒充原作,别恶意损害作品。我们尊重。 今天,Seedance2.5 的加持下,AI工具的门槛一夜塌了, 设计和表达的门槛浮出水面。这大概是2026年做 AI 音乐,做MV,做短剧内容的人,最需要想明白的一件事。
← 返回首页全部文章