AI 视频 100 万播放,AI 视频配音工作流开源了,你的 Agent 一秒学会
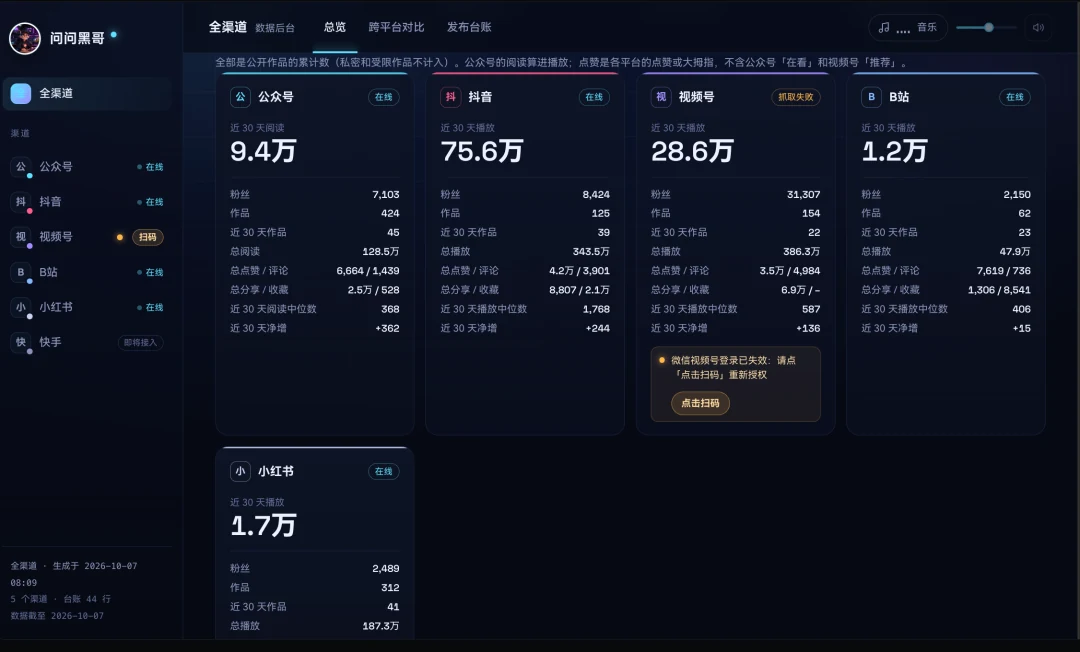
最近发的视频综合播放超了 100 万然后我发现一个很有意思的事情,上周我发了一条视频,从头到尾的声音都不是我录的,是 AI 照着我的声音念的。
那条视频在抖音的收藏
比点赞还多
502 个收藏,355 个赞。
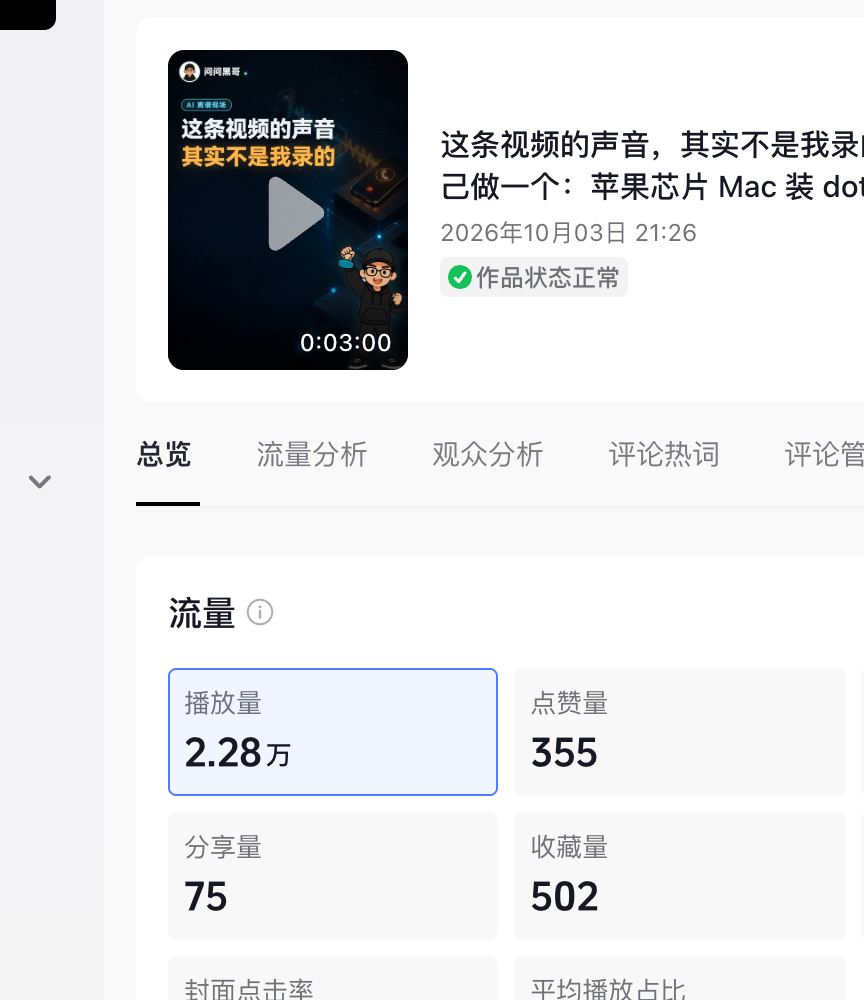
收藏比点赞多,一般只说明一件事,大家想自己动手试一遍,但视频里装不下完整步骤。
所以这篇我把步骤一条一条写出来,你照着敲命令就行。
写这篇之前,我又在一个全新的环境里,按项目最新版从头装了一遍,每条命令都跑通了才写进来。
先说清楚用的是什么。
这个项目叫 dots.tts,是小红书团队今年 6 月开源的语音合成模型,协议是 Apache 2.0,个人用、商用都免费。
它能做的事情很简单。你给它一小段自己的录音,再告诉它这段录音里说的是什么,它就能学会你的音色,以后你打字,它就用你的声音念出来。
windows 用户直接用原版,原版主要跑在英伟达显卡上。苹果电脑用户要用社区开发者移植的版本,叫 dots-tts-mlx,MLX 是苹果给自家芯片做的计算框架,你可以把它理解成「专门给 M 系列芯片修的高速公路」。
一个参数都不用训练,基础模型原封不动,只是另外给你登记了一份声音档案。
这点很重要。很多人一听克隆声音,以为要准备几小时录音、租显卡训练好几天,完全不用。
我自己那份声音档案,用的就是一段 16 秒的录音。
没错,16 秒就足够制作了。
这些视频都是 AI 音频的效果⬇️
动手之前,先对一下你的电脑。
以下教程我就直接放 macos 的,M1、M2、M3、M4 都行,老款 Intel 芯片的 Mac 跑不了。(windows 过程是一样的,下载官方版本就行)
小 tips:本文如果你看着比较吃力,无从下手,直接把文章转发给你的 agent(codex 或者 workbuddy 这些都行)然后给他一条你的干净人声,直接就能克隆了。
(成功的话记得来点个赞!关注我收获更多落地工作流)
内存建议 16GB 起步。我实测用 16 秒录音登记声音的时候,内存峰值冲到了 25GB(我那台是 64GB 的机器,所以没感觉)。官方说明里参考录音短一点,大约 10GB 就够,所以 16GB 的机器记得把录音控制在 10 秒以内。
硬盘留出 3GB 左右,模型本身 2.4GB。
还要一个 Python,版本 3.10 或更新的。
打开「终端」输入下面这行,能看到版本号就说明有了。
1 | python3 --version |
如果提示找不到命令,先去 Python 官网装一个,装完再回来。
好,开始。
第一步,给它单独建一个干净的环境,再把工具装进去。单独建环境的好处是,装坏了直接删掉文件夹重来,不影响电脑里别的东西。
1 | python3 -m venv ~/dots |
这里有个小坑我替你踩过了。**
项目说明页上的安装命令,版本号还写着老的 v0.3.1,实际最新版已经是 v0.7.0,直接照抄会装到旧版本,所以命令末尾我写的是 v0.7.0。
装完输入
dots-tts --help
能看到一长串参数说明就对了。
第二步,下载模型。它用的是 Hugging Face 上别人已经转换好的版本,不用自己转换。
1 | pip install -U huggingface_hub |
int4 是压缩过的版本,大小从原版的 9GB 降到 2.4GB,作者在几种语言上测过,没发现念得更差,我自己用的也是它。
下载慢或者中途断了,基本都是网络问题,重新跑一遍同一条命令就会接着下。
第三步,录一段自己的声音。这一步决定了最后像不像,值得多花两分钟。
找个安静的房间,用手机的语音备忘录或者 Mac 自带的语音备忘录都行。像平时说话一样念 8 到 10 秒,不用播音腔,越自然越好。
录音不是越长越好,官方说明里讲得很清楚,长录音不会更像,只会更慢、更吃内存。
我那段 16 秒,其实是从一段 86 秒的录音里挑出来最干净的一截。
录完的文件一般是 m4a 格式,它要的是 wav 格式。Mac 自带一个转换工具,不用装任何软件。
1 | afconvert -f WAVE -d LEI16@48000 -c 1 ~/Desktop/录音.m4a ~/Desktop/me.wav |
把命令里的「录音.m4a」换成你自己的文件名就行。
第四步,登记声音档案。这一步要两样东西,录音文件,还有录音里说的原话。
1 | dots-tts --model ~/dots-weights/int4 --enroll \ |
原话必须一字不差,多一个字少一个字,出来的声音都会走样。
拿不准就对着录音逐字听一遍再填。
我这边登记一次用了 46 秒,跑完桌面上会多出一个叫 me.dtprofile 的文件夹,这就是你的声音档案,以后一直能用。
第五步,让它用你的声音念。
1 | dots-tts --model ~/dots-weights/int4 --profile ~/Desktop/me.dtprofile \ |
跑完桌面上会出现一个「第一句_000.wav」,双击就能听。
ZH 是告诉它这是中文。
我这次生成一句三十来个字的话,连加载模型一共 78 秒。
每跑一次命令都要重新加载一遍模型,所以别一句一句地跑。
要念一大段,就把整段文字放进去,在命令最后加上 --long。长文一定要加 –long,它会一句一句念完再拼起来,不加的话念到后面容易漏字。
到这里你就有了一个会用你声音说话的 AI。
不过别指望它一次完美。
我做那期讲大模型的视频,一共 50 句,有 6 句念得不对,要重新生成。有一次「猜测」的猜,被念成了拆开的拆,还有的时候句子开头那个字直接被吞掉了。就是这条⬇️
所以我现在的做法是,每念完一句,都用语音识别转回文字,跟原稿对一遍,对不上的就换个随机数重念。手里没有这套工具的话,自己戴耳机听一遍也行,就是费点耳朵。(如果你 token 够,配置也够,这个步骤可以交给 AI 审核,大大节省自己的时间)
还有一个老用户才会碰到的坑。**
以前用旧版登记过的声音档案,升级到 v0.5.0 以后的版本会读不出来,作者改了档案格式,重新登记一次就好,模型不用重新下载。
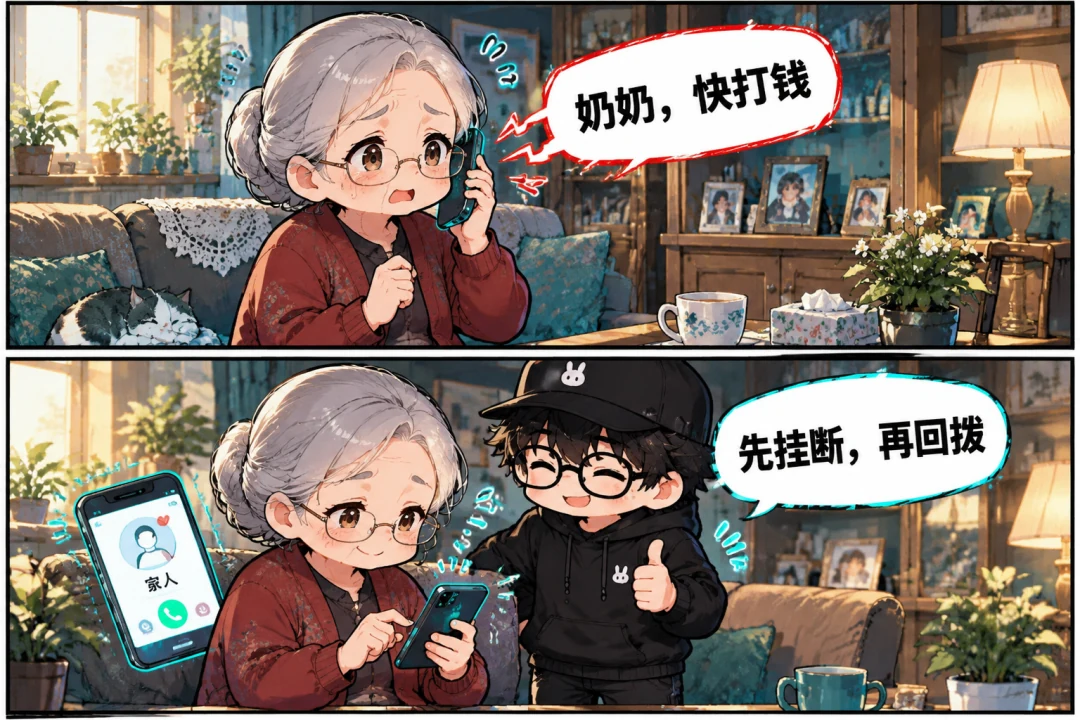
写到这儿,我得说点不那么轻松的。
我能用 16 秒录音做出自己的声音,骗子也能用你发在网上的一段语音,做出你的声音。
这不是吓唬人。**
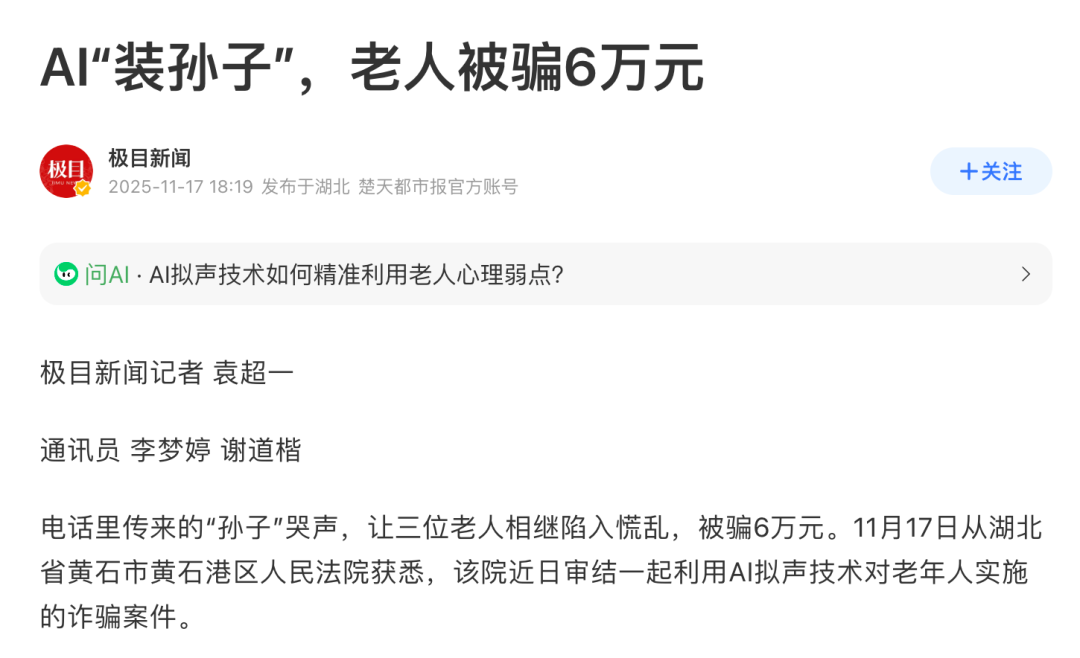
今年 2 月最高人民法院公布的典型案例里,湖北黄石有骗子用 AI 模拟孙子的声音打电话,从 3 位老人手里骗走了 6 万元,三位老人都说,电话里确实是自己孙子的声音。
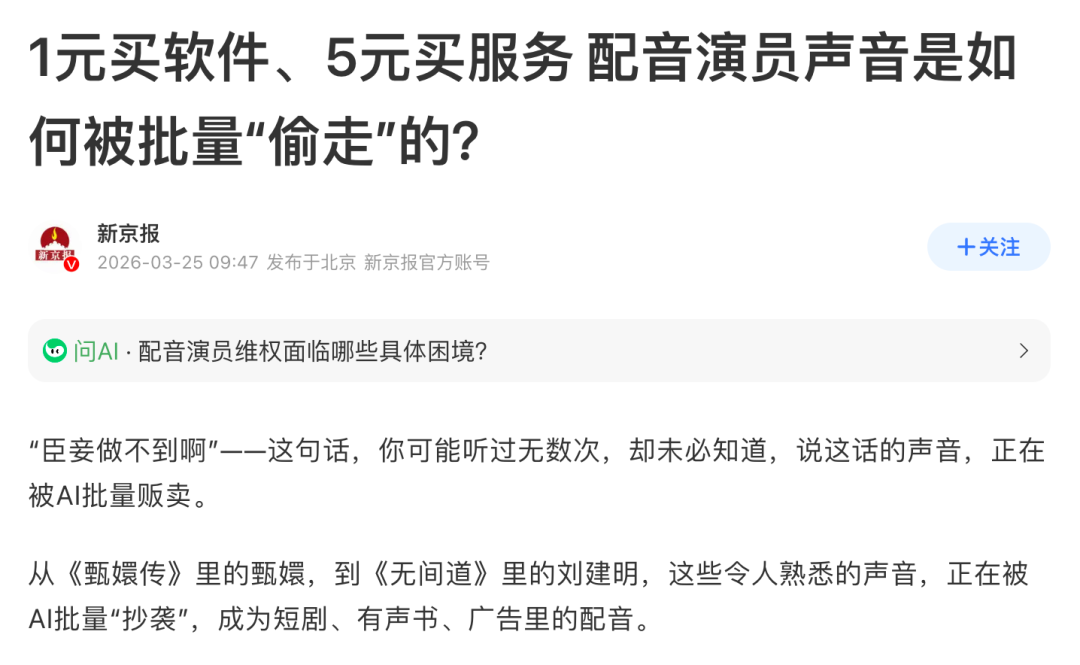
新京报还调查过,交易平台上克隆声音的服务,软件标价低到 1 块钱。
(其实都是开源免费软件。。。
声音越像,转钱之前越要多确认一次。
防这种骗局,记住两招就够了。
第一招,挂断,用手机里存好的号码打回去。别在原来那通电话里核实,也别加对方发来的新号码。
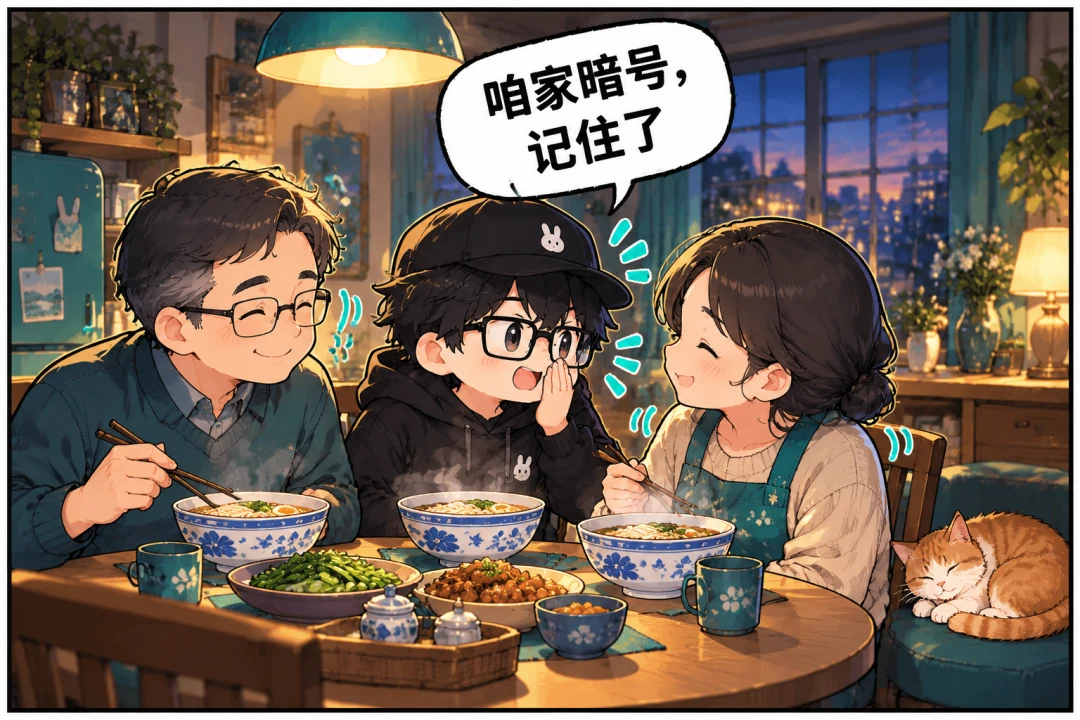
第二招,跟家里人约一个暗号,只有你们知道的一句话。电话里提到钱,先问暗号,答不上来马上停。美国联邦调查局 2024 年的公开提醒里,也是这么建议的。
另外,接到陌生来电对方不说话的时候,自己也先别出声,少给人录走一段干净的声音样本。
还有两条规矩,自己用的时候要守住。
用 AI 声音发内容,要主动声明是 AI 生成的。
就像我的每条视频,都标注了 AI 生成。⬇️
国家网信办等四部门的《人工智能生成合成内容标识办法》去年 9 月 1 日起施行,音频要加提示。各个平台发布页面上也都有「内容由AI生成」的勾选,发之前记得勾上。
别拿别人的声音去克隆,哪怕只是开玩笑。 北京互联网法院 2024 年判过一个案子,未经授权用配音师的声音做 AI 配音,判赔 25 万元。
回到开头那条视频。
我当时在结尾说了一句话,声音越像,越要多确认一次,放到这篇文章里,一样成立。
技术本身没有好坏,它能帮我一个人做完一整条视频的配音,也能被人拿去骗老人的养老钱。工具交到谁手里,看的永远是人。
你学会了这一招,记得顺手把防骗那两招也告诉相亲相爱一家人,以及你的好闺蜜、好基友。
感谢你看到这里,到这里全文就结束了,喜欢的话点个赞、在看💗,谢谢你的 3 连,我是黑哥,不吹AI也不恐惧AI,只说真话。
小 tips:本文如果你看着比较吃力,无从下手,直接把文章转发给你的 agent(codex 或者 workbuddy 这些都行),然后给他一条你的干净人声,直接就能克隆了。
(成功的话记得来点个赞!关注我收获更多落地工作流)
补充说明下为什么没放连接,因为我被违规搞怕了,辛苦大家自己去搜一下。。。