生成视频不难,难的是读懂故事
故事写完,然后呢?
这是作者”摇摆时间线”在微博里抛出的问题。他做了一个叫 narrative-to-screen-reader(叙事转译)的开源 Skill,5 月 29 日刚更到 v2.0.0。
它的功能不是”替你写剧本”,是给你和剧本之间,硬塞了一道关卡——先读懂故事,再谈改编。
这件事听着像废话,做起来是反人性的。
因为我观察到的真实情况是:
90% 的人拿到一个故事,第一反应是”怎么改成剧本”。
这中间被跳掉的一步叫”读懂”。
问题
今年我看了不下 50 个 AI 短剧项目。
跑视频的有 seedance2-skill 这种把提示词打磨到极致的,有 openclaw-video-stack 这种把 30 秒成本从 67 块打到 16 块的——昨天的文章刚写过。
但几乎所有项目都在同一个地方卡住:
故事本身没人读懂。
一个 6 万字的长会话 AI 角色扮演跑完了,作者觉得”我有一个好故事了”,扔给 AI 改剧本。
AI 给他的是什么?悲剧变大团圆、复杂角色变扁平工具人、精心设计的叙事结构被简化为三幕式流水线产品。
为什么?
因为 AI 不知道这个故事本来想说什么。它只会”改”,不会”读”。
narrative-to-screen-reader 干的就是这件事。
观点
观点 1:能生成画面,不等于能拍片子
生成视频的工具已经很多了。Seedance 2.5、Runway、可灵、即梦,都能跑。
但”跑”和”拍”是两种活儿。
跑是把文字描述变成画面,核心是技术能力。拍是把一段故事变成可看的影像,核心是叙事能力。
narrative-to-screen-reader 不做前者,专做后者——它强迫你先做一件大多数 AI 工具不愿意做的事:先判断这个故事值不值得做。
判断的标准不是”有没有画面感”,是这四样:
- 有没有人物动机
- 有没有场景承载
- 有没有关系推进
- 有没有物件链和母题
这四样少一样,故事就是”情绪堆砌”或”概念宣言”,不是故事。
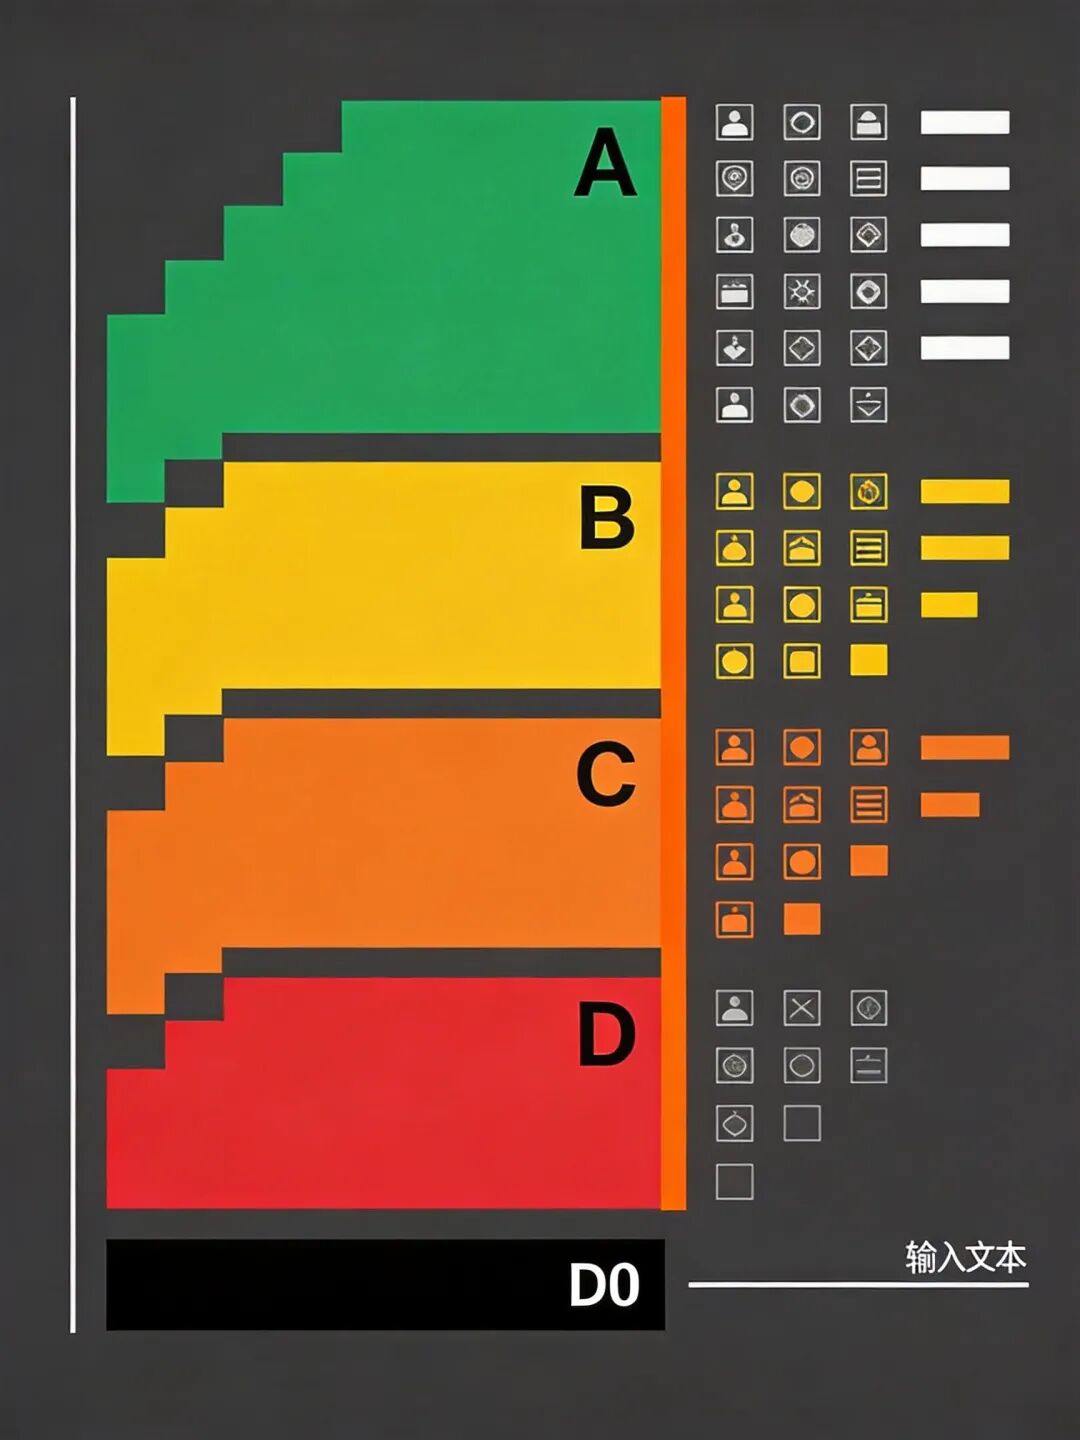
诊断等级 A/B/C/D/D0 对应不同的模块加载策略
金句:能生成画面,不等于能拍片子。
观点 2:同一个故事,给 7 个工种看
这个 Skill 最反常识的设计是:同一个故事,输出 7 种读本。
不是把所有信息塞给所有人,是按工种拆分:
- 快速诊断 → 所有人(1000-2000 字,A/B/C/D/D0 五级)
- 完整开发读本 → 开发团队、编剧(母文档)
- 演员读本 → 演员(角色怎么活着、怎么说话、怎么防、怎么靠近)
- 编剧改编读本 → 编剧(必须保留 / 可删 / 可扩 / 改编风险)
- 导演视听读本 → 导演、摄影、美术、声音(视觉母题、空间、光线、镜头方向)
- 制片摘要 → 制片、平台、投资人(值不值得做、适合什么形态、最容易怎么死)
- AI 剧本化提示包 → 下一阶段 AI(角色规则、不可改项、剧本化 Prompt)
为什么是 7 种?
因为演员拿到”完整开发读本”是没用的,他不需要知道结构理论;制片拿到”演员读本”也是没用的,他不需要知道身体逻辑。
同一个故事,给不同的人看,是不同的东西。
这是 v2.0 之前很多 AI 工具搞砸的关键——它们给所有人输出同一份”分析报告”。
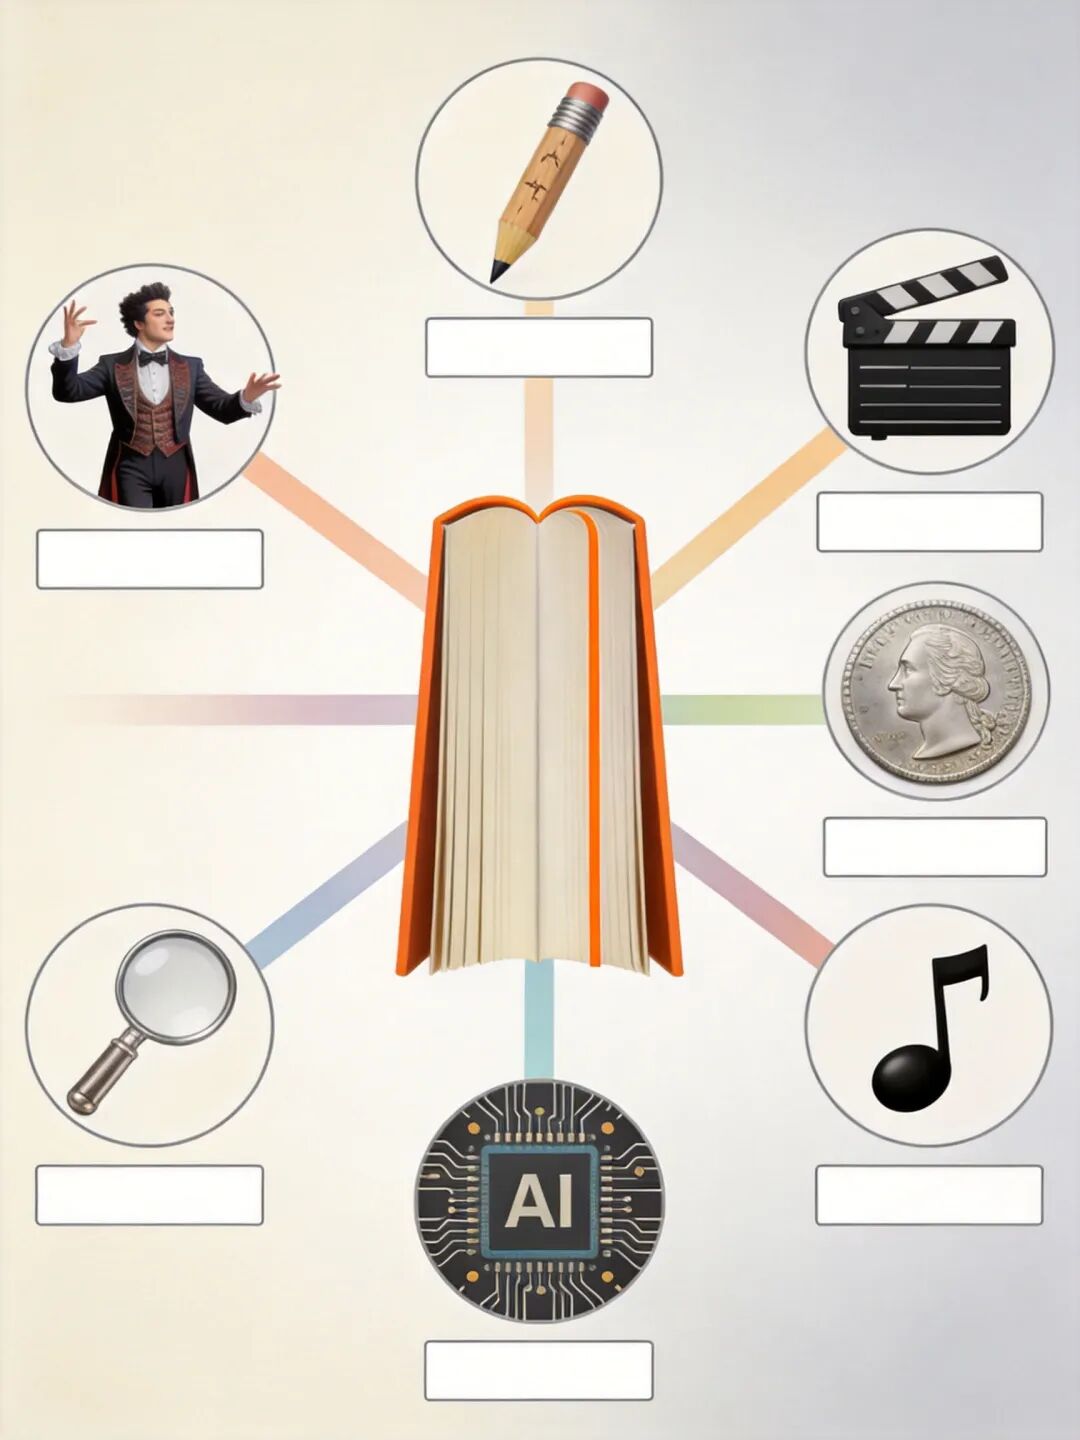
同一个故事,按工种输出 7 种读本
金句:给演员看的不是结构,给制片看的不是身体。
观点 3:v2.0 最大的改动不是新功能,是让 AI 学会说”先等等”
我必须单独说一说这个改动。
v2.0 引入了 🔴 CHECKPOINT 强制暂停机制:
快速诊断完成 → 展示诊断结果 → 必须等用户确认 → 才能继续生成读本
这看着像”贴心”,本质上是把”AI 主动权”交还给用户。
v1.x 的问题是什么?AI 跑完诊断,激动了,自动一口气输出完整开发读本 + 演员读本 + 导演读本 + 制片摘要 + AI 提示包。
你打开一看:5 个 .md 文件,但你想看的只有 1 个。
v2.0 的解法是:AI 跑完诊断就停,告诉你”这是 A 级 / B 级 / C 级,推荐先做哪几个模块”,然后等你点头。
这是工具的克制。
我之前写过的所有 AI 工具都在卷”能自动干多少事”,这个 Skill 反着来——它先告诉你”不该自动干哪些事”。
v2.0 CHECKPOINT 强制暂停机制示意
金句:让 AI 学会”先等等”,比让它学会”快跑”难得多。
观点 4:5 级诊断,藏着影视开发的工作流
快速诊断输出 A/B/C/D/D0 五级,每一级对应不同的模块加载:
- A:完整开发读本优先,再按需拆演员 / 导演 / 制片 / AI
- B:先做编剧改编读本 + 角色补强
- C:只做开发路径判断,不做完整读本
- D:只做最小重构方案
- D0:直接终止(内容红线:未成年人性剥削、奴役人口贩卖、角色仅作欲望对象)
这个分级不是”打分”,是”工作流入口”。
A 级故事直接进完整读本流水线;B 级故事要先补局部(人物厚度或场景承载);C 级故事不急开发,先判断”该走哪条路径”;D 级故事重写;D0 级故事停。
作者甚至给了对应的 reference 加载路由表——A 级只加载完整开发读本规则,演员/导演/制片模块按需加载,不一次性塞进上下文。
这是工程化思维,把”影视开发方法论”和”LLM 上下文管理”两个问题一起解了。
金句:诊断等级不是分数,是工作流的入口。
观点 5:作者为什么要分两步
narrative-to-screen-reader 是作者的第二个 Skill。
第一个叫 tragedy-narrative-guard(悲剧叙事哨兵),是给 AI 长会话角色扮演用的——守住”悲剧不被 AI 写甜”的防御结构。
两者关系是:
第一步:
tragedy-narrative-guard→ 用 AI 跑出一个真实的故事第二步:
narrative-to-screen-reader→ 把故事读懂,翻译成影视开发材料第三步:编剧 / AI 正式剧本化
第一步是”造东西”,第二步是”读东西”,第三步是”改东西”。
大多数人跳过第二步。
作者在微博里说了一句话挺重:
“一个真正成立的故事,还是要你自己来写。它只是帮你把已经有的东西,变成可以被更多人使用的形态。”
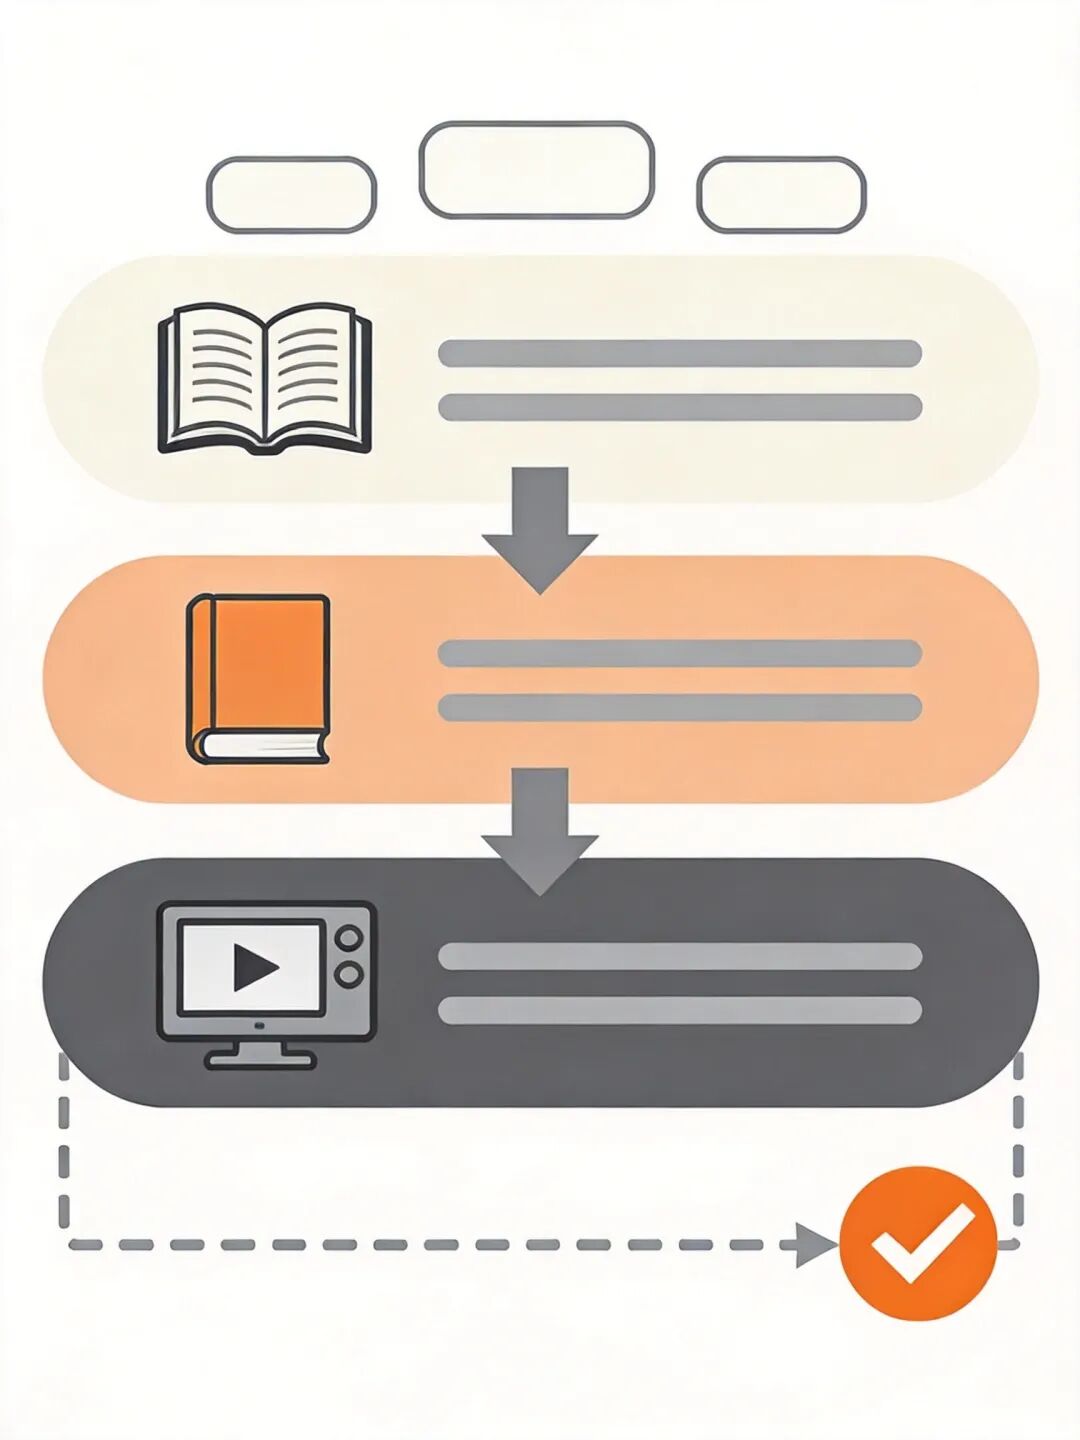
从故事到视频的完整流程
这不是客套。这是 Skill 的边界。
金句:大多数人跳过”读”,直接从”造”跳到”改”。
案例
作者公开了 6 个测试案例,最有冲击力的是这两个:
案例 1:《同一条河》
- 规模:37,000 字 AI 长会话,姜宁 × 摇摆
- 类型:错过型爱情悲剧
- 诊断:A 级
- 结果:5 种读本全出(完整开发、演员、导演、制片、AI 提示包)
- 验证点:冷防御、残迹终局、物件链、余韵式收束
案例 2:《另说》
- 规模:60,000 字 AI 长会话,韩欣 × 吴语
- 类型:热防御人物,团圆终局 (不是悲剧)
- 诊断:A 级
- 结果:6 种读本全出
- 验证点:Skill 不强行套悲剧,它按角色人格和结构判断该有的终局
第二个案例是关键——
我见过太多 AI 工具”看到悲剧就写甜,看到团圆就写悲”。narrative-to-screen-reader 不做这种事。它承认:团圆终局可以是 A 级,前提是结构和人物撑得起。
这才是”读懂”,不是”教化”。
总结
昨天写 seedance2-skill,解决的是”提示词怎么写”。前天写 openclaw-video-stack,解决的是”视频怎么跑”。
今天写 narrative-to-screen-reader,解决的是”故事怎么读”。
读懂故事 → 改好提示词 → 跑完视频,这条工作流在传统影视行业里,是好几年专业训练的成果。现在被一个叫 zhlmi 的”数字影像工程师”用 19 个版本迭代、3000+ 行 SKILL.md 写了出来。
这不是炫技,是补缺。
行业里被跳掉的那一步,被一个人补上了。
行动引导
值得用
- 已有 AI 长会话作品想影视化的人
- 写短篇 / 网文想看影视化路径的作者
- 行业剧、群像、长篇改编项目(开发入口不清楚时)
不值得用
- 只有概念没有具体故事的人
- 只想直接生成视频、不在乎故事结构的人
- 已经成熟的项目(已有专业团队在做开发读本)
怎么开始
- GitHub:
https://github.com/zhlmi/narrative-to-screen-reader - 推荐入口:先发故事 → 拿快速诊断 → 看 A/B/C/D/D0 哪一级 → 按推荐顺序做模块
- **不要一上来就要求”全套输出”**,那是 v1.x 时代的用法
v2.0 关键更新
- 🔴 CHECKPOINT 强制暂停
- 诊断→Reference 路由表
- 长文本分批协议(>50KB 自动分批)
- 极端输入处理(<500字最小可行性、>200KB 范围询问)
- 编剧读本角色补强指引 + 场景保留 3 条评分
如果你手上有一个故事,故事写完之后 ——
不是”然后怎么改”,是”然后怎么读”。
我是AI剧-阿丙,记录转型创作的真实探索